Pláticas del SeminarioDel texto a la inteligencia: la revolución de los LLMs
Presenta: Dra. Ximena Gutierrez-Vasques Fecha:17 de marzo de 2026 / 13:30 hrs. Resumen: En esta presentación se ofrecerá un recorrido por los principales elementos que han dado origen a los que concebimos como inteligencia artificial (IA) en la actualidad, con un énfasis especial en el procesamiento del lenguaje natural (PLN). Se analizará el origen y la evolución de las tecnologías del lenguaje, así como las razones por las cuales los grandes modelos de lenguaje (LLMs) han transformado profundamente el panorama tecnológico. Asimismo, se explorarán los nuevos paradigmas y tendencias que desafían las concepciones clásicas del aprendizaje automático y abren horizontes hacia nuevas posibilidades científicas y tecnológicas. ------------------------------------------ Lógica en Inteligencia Artificial
Presenta: Dra. Lourdes del Carmen González Huesca Fecha: 14 de abril de 2026 / 15:00 hrs. Resumen: En esta charla abordaremos la importancia de diversas lógicas, presentes en áreas computacionales y útiles para la inteligencia artificial. Algunos sistemas lógicos son parte esencial de lo que conocemos como 'sistemas inteligentes', por ejemplo, lógica de primer orden, lógicas modales, lógica difusa, entre otras. Estas lógicas fundamentan herramientas y metodologías en áreas como razonamiento automatizado, programación lógica, representación del conocimiento, sistemas expertos, etc. ------------------------------------------ Un sistema HTN para asistir en la planificación creativa. Aplicación al seguimiento de personajes en Dungeons & Dragons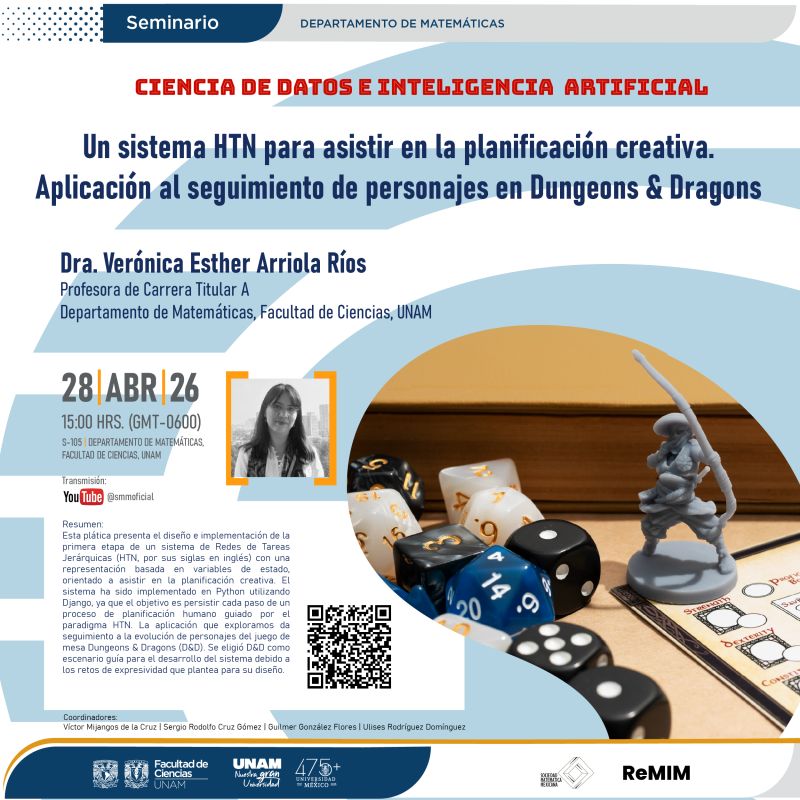
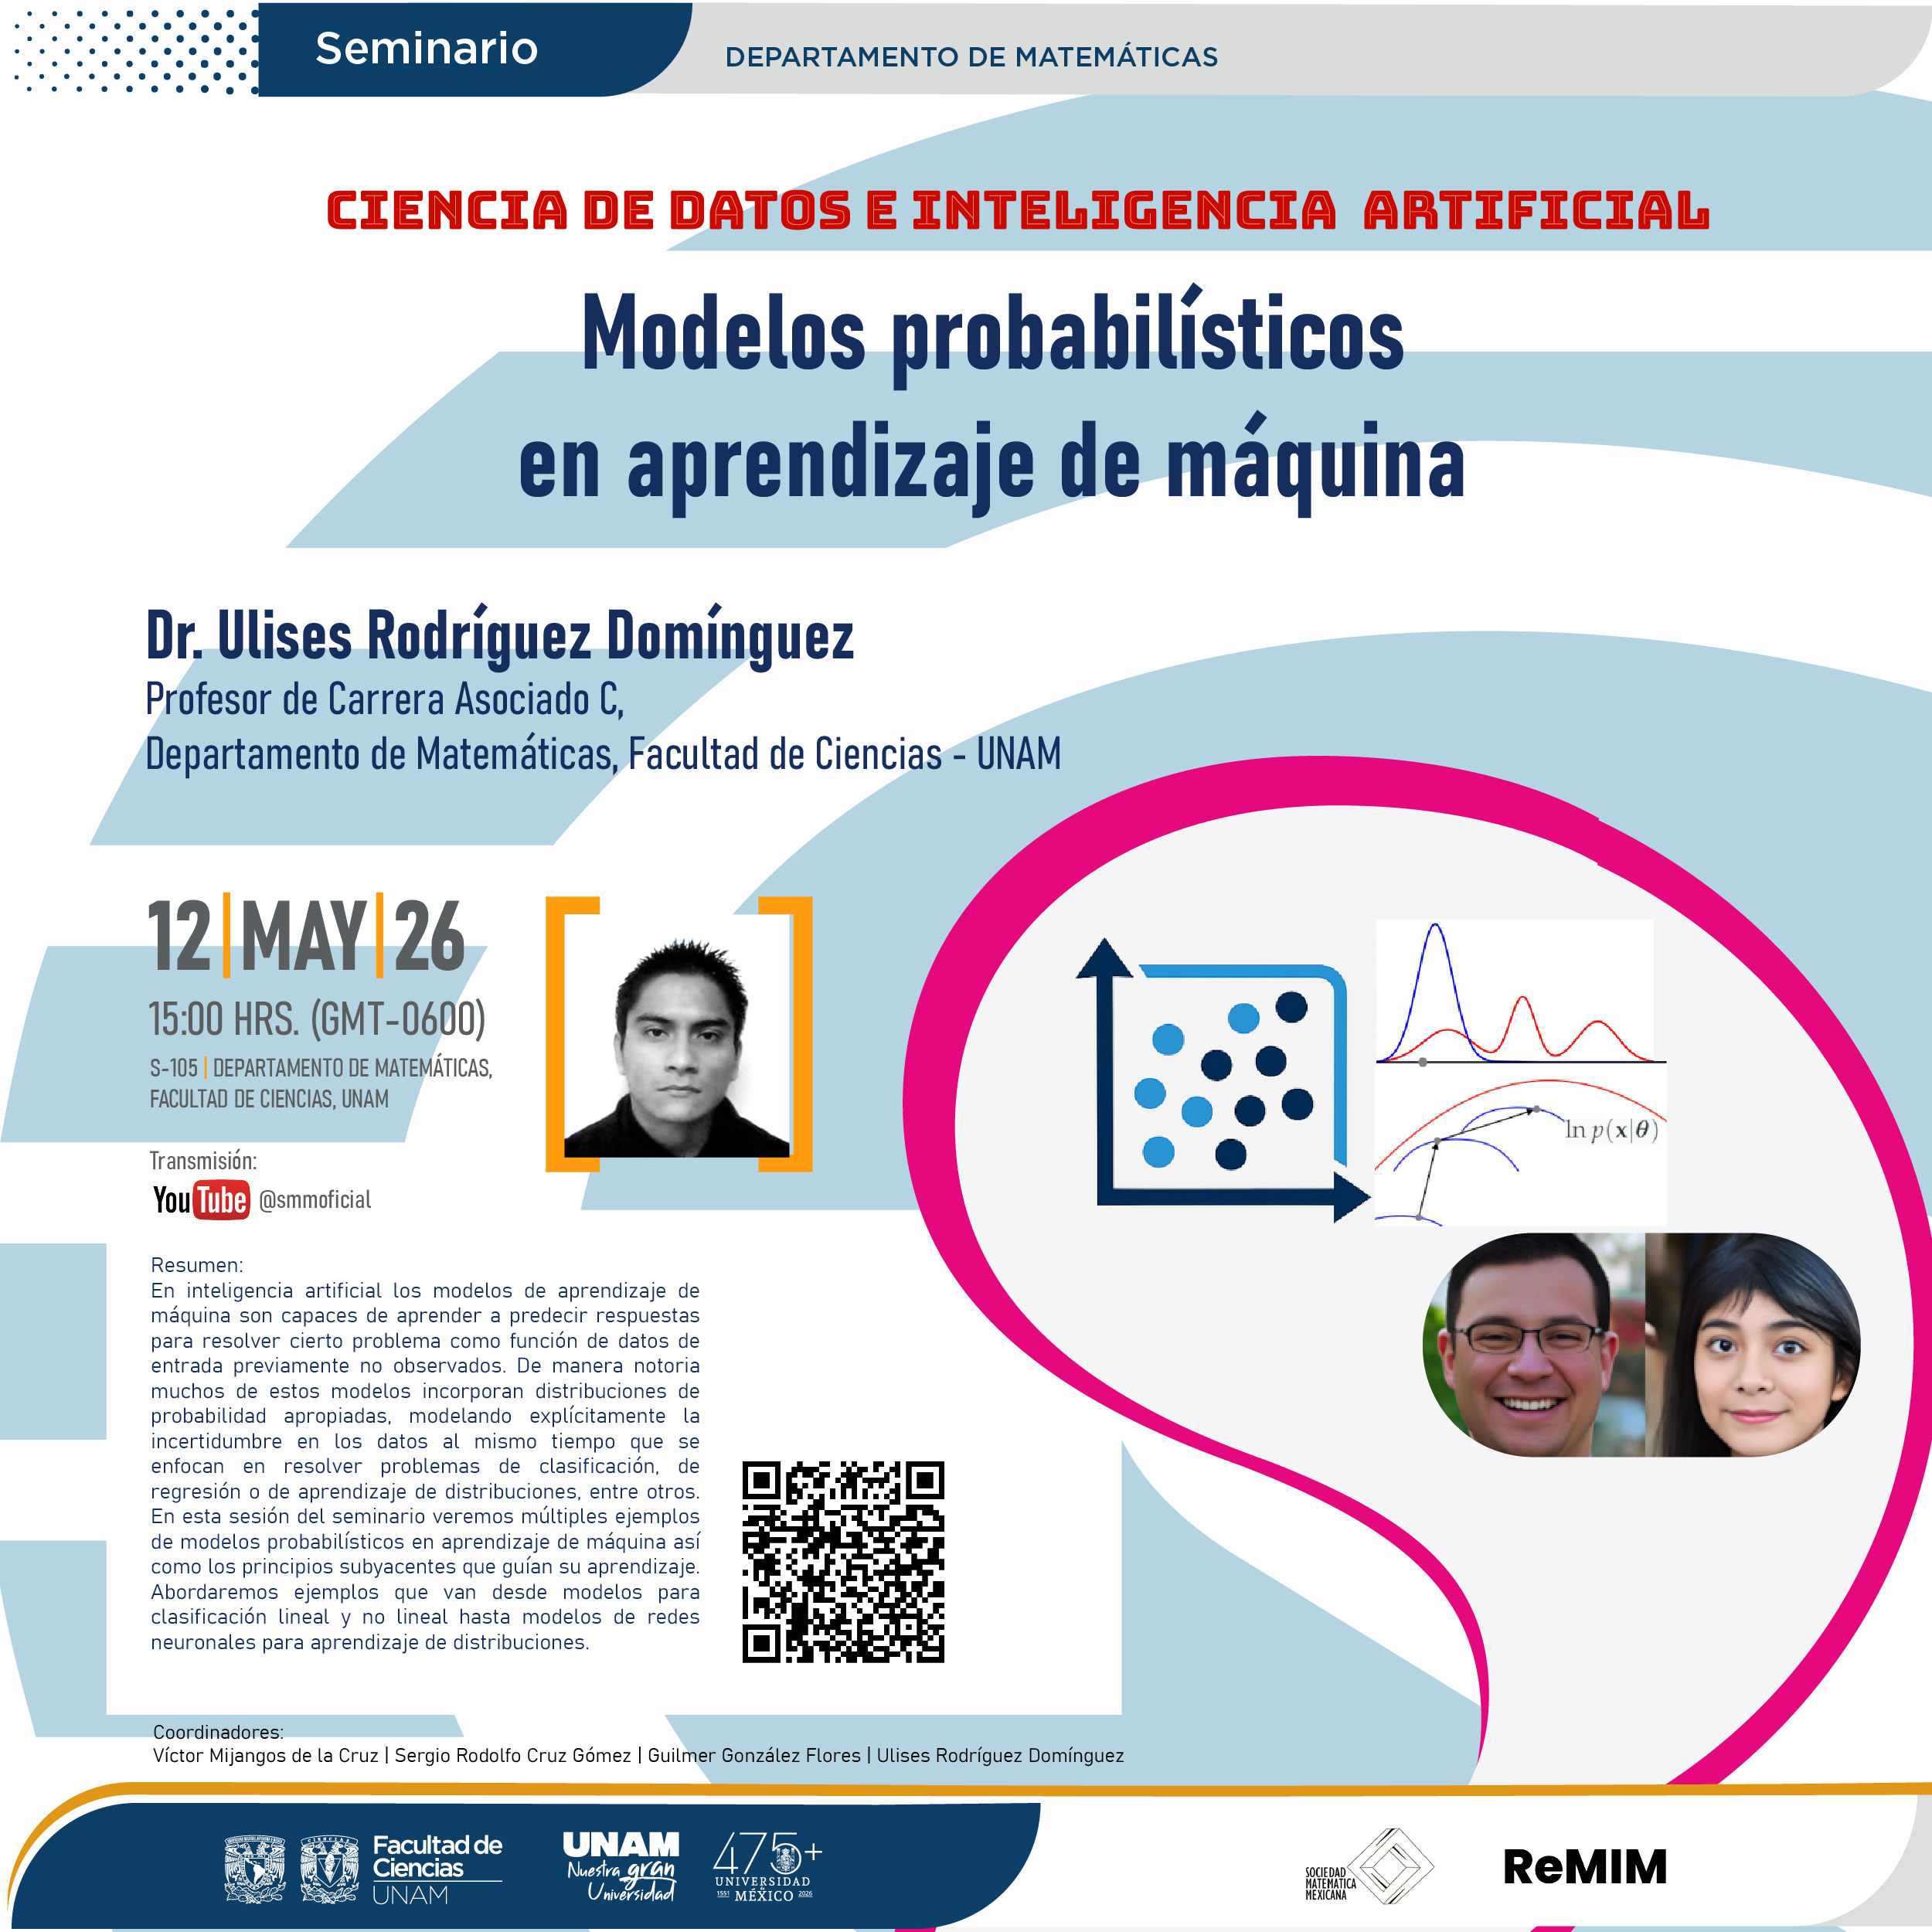
Presenta: Dra. Verónica Esther Arriola Ríos Fecha:28 de abril de 2026 / 15:00 hrs. Resumen: Esta plática presenta el diseño e implementación de la primera etapa de un sistema de Redes de Tareas Jerárquicas (HTN, por sus siglas en inglés) con una representación basada en variables de estado, orientado a asistir en la planificación creativa. El sistema ha sido implementado en Python utilizando Django, ya que el objetivo es persistir cada paso de un proceso de planificación humano guiado por el paradigma HTN. La aplicación que exploramos da seguimiento a la evolución de personajes del juego de mesa Dungeons & Dragons (D&D). Se eligió D&D como escenario guía para el desarrollo del sistema debido a los retos de expresividad que plantea para su diseño. ------------------------------------------ Título: Modelos probabilísticos en aprendizaje de máquina
Ponente: Dr. Ulises Rodríguez Domínguez (FC-UNAM) Resumen: En inteligencia artificial los modelos de aprendizaje de máquina son capaces de aprender a predecir respuestas para resolver cierto problema como función de datos de entrada previamente no observados. De manera notoria muchos de estos modelos incorporan distribuciones de probabilidad apropiadas, modelando explícitamente la incertidumbre en los datos al mismo tiempo que se enfocan en resolver problemas de clasificación, de regresión o de aprendizaje de distribuciones, entre otros. En esta sesión del seminario veremos múltiples ejemplos de modelos probabilísticos en aprendizaje de máquina así como los principios subyacentes que guían su aprendizaje. Abordaremos ejemplos que van desde modelos para clasificación lineal y no lineal hasta modelos de redes neuronales para aprendizaje de distribuciones.
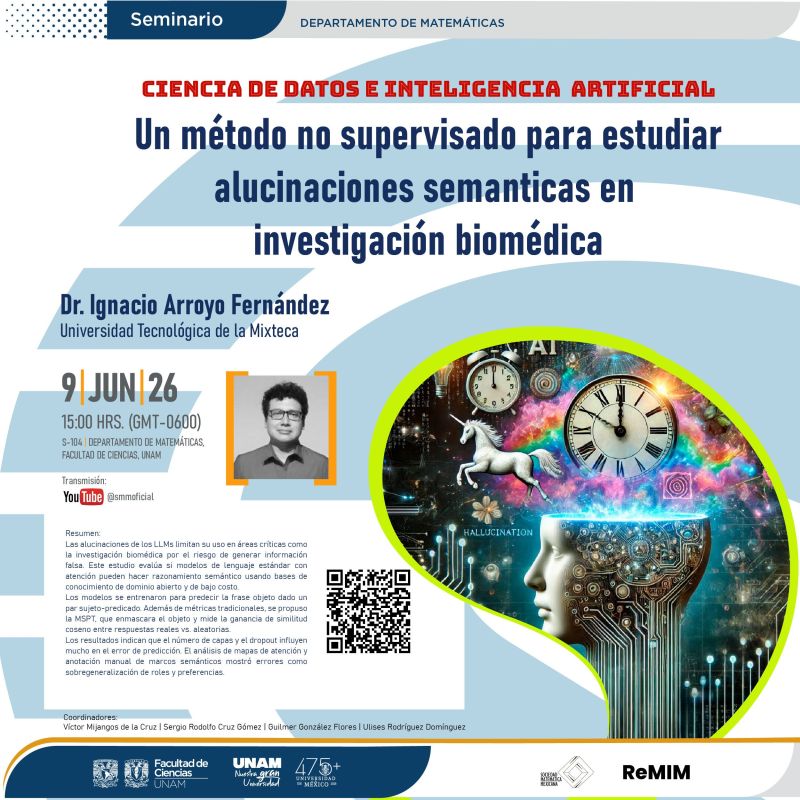
------------------------------------------ Título: Un método no supervisado para estudiar alucinaciones semanticas en investigación biomédica
Ponente: Dr. Ignacio Arroyo Fernández (Universidad de la Mixteca) Resumen: Las alucinaciones en modelos de lenguaje son un problema que afecta negativamente la adopción de la Inteligencia Artificial en áreas críticas como es el caso de la investigación biomédica, ya que puede causar errores y adquisición de información falsa. Para contribuir en la solución de este problema, este estudio examina si los modelos de lenguaje estándar de atención pueden realizar razonamiento en el nivel semántico a partir de bases de conocimiento de dominio abierto a un bajo costo. Se evaluaron arquitecturas con mecanismo de atención GRU, LSTM y Transformers standard utilizando tres bases de conocimiento y sus combinaciones: ConceptNet para sentido común, una base OpenIE genérica y otra extraída de 1,200 resúmenes PubMed sobre nueve enfermedades crónicas (52000 a 652000 tripletas de conocimiento en total). Los modelos se entrenaron para predecir frases objeto a partir de pares sujeto-predicado. Además de las métricas tradicionales, se introdujo la Prueba de Preferencia Seleccional Basada en Significado (MSPT), la cual enmascara frases objeto y mide ganancias de similitud coseno entre referencias reales y aleatorias. Un análisis con bosques aleatorios mostró una influencia importante del número de capas y dropout en la pérdida de predicción. Además, un análisis cualitativo de los mapas de atención y la anotación manual de marcos semánticos, roles y preferencias de selección mostró los patrones de errores semánticos de los modelos, incluyendo la sobre generalización sistemática en roles y preferencias. Los resultados muestran que el mejor modelo de lenguaje GRU logró una brecha MSPT del 20.7%, mientras que el mejor Transformer alcanzó 9.9%; ambos muy significativos, superando a las líneas de base LSTM y demostrando la viabilidad del razonamiento semántico biomédico con bases de conocimiento fáciles de obtener y arquitecturas neuronales ligeras.
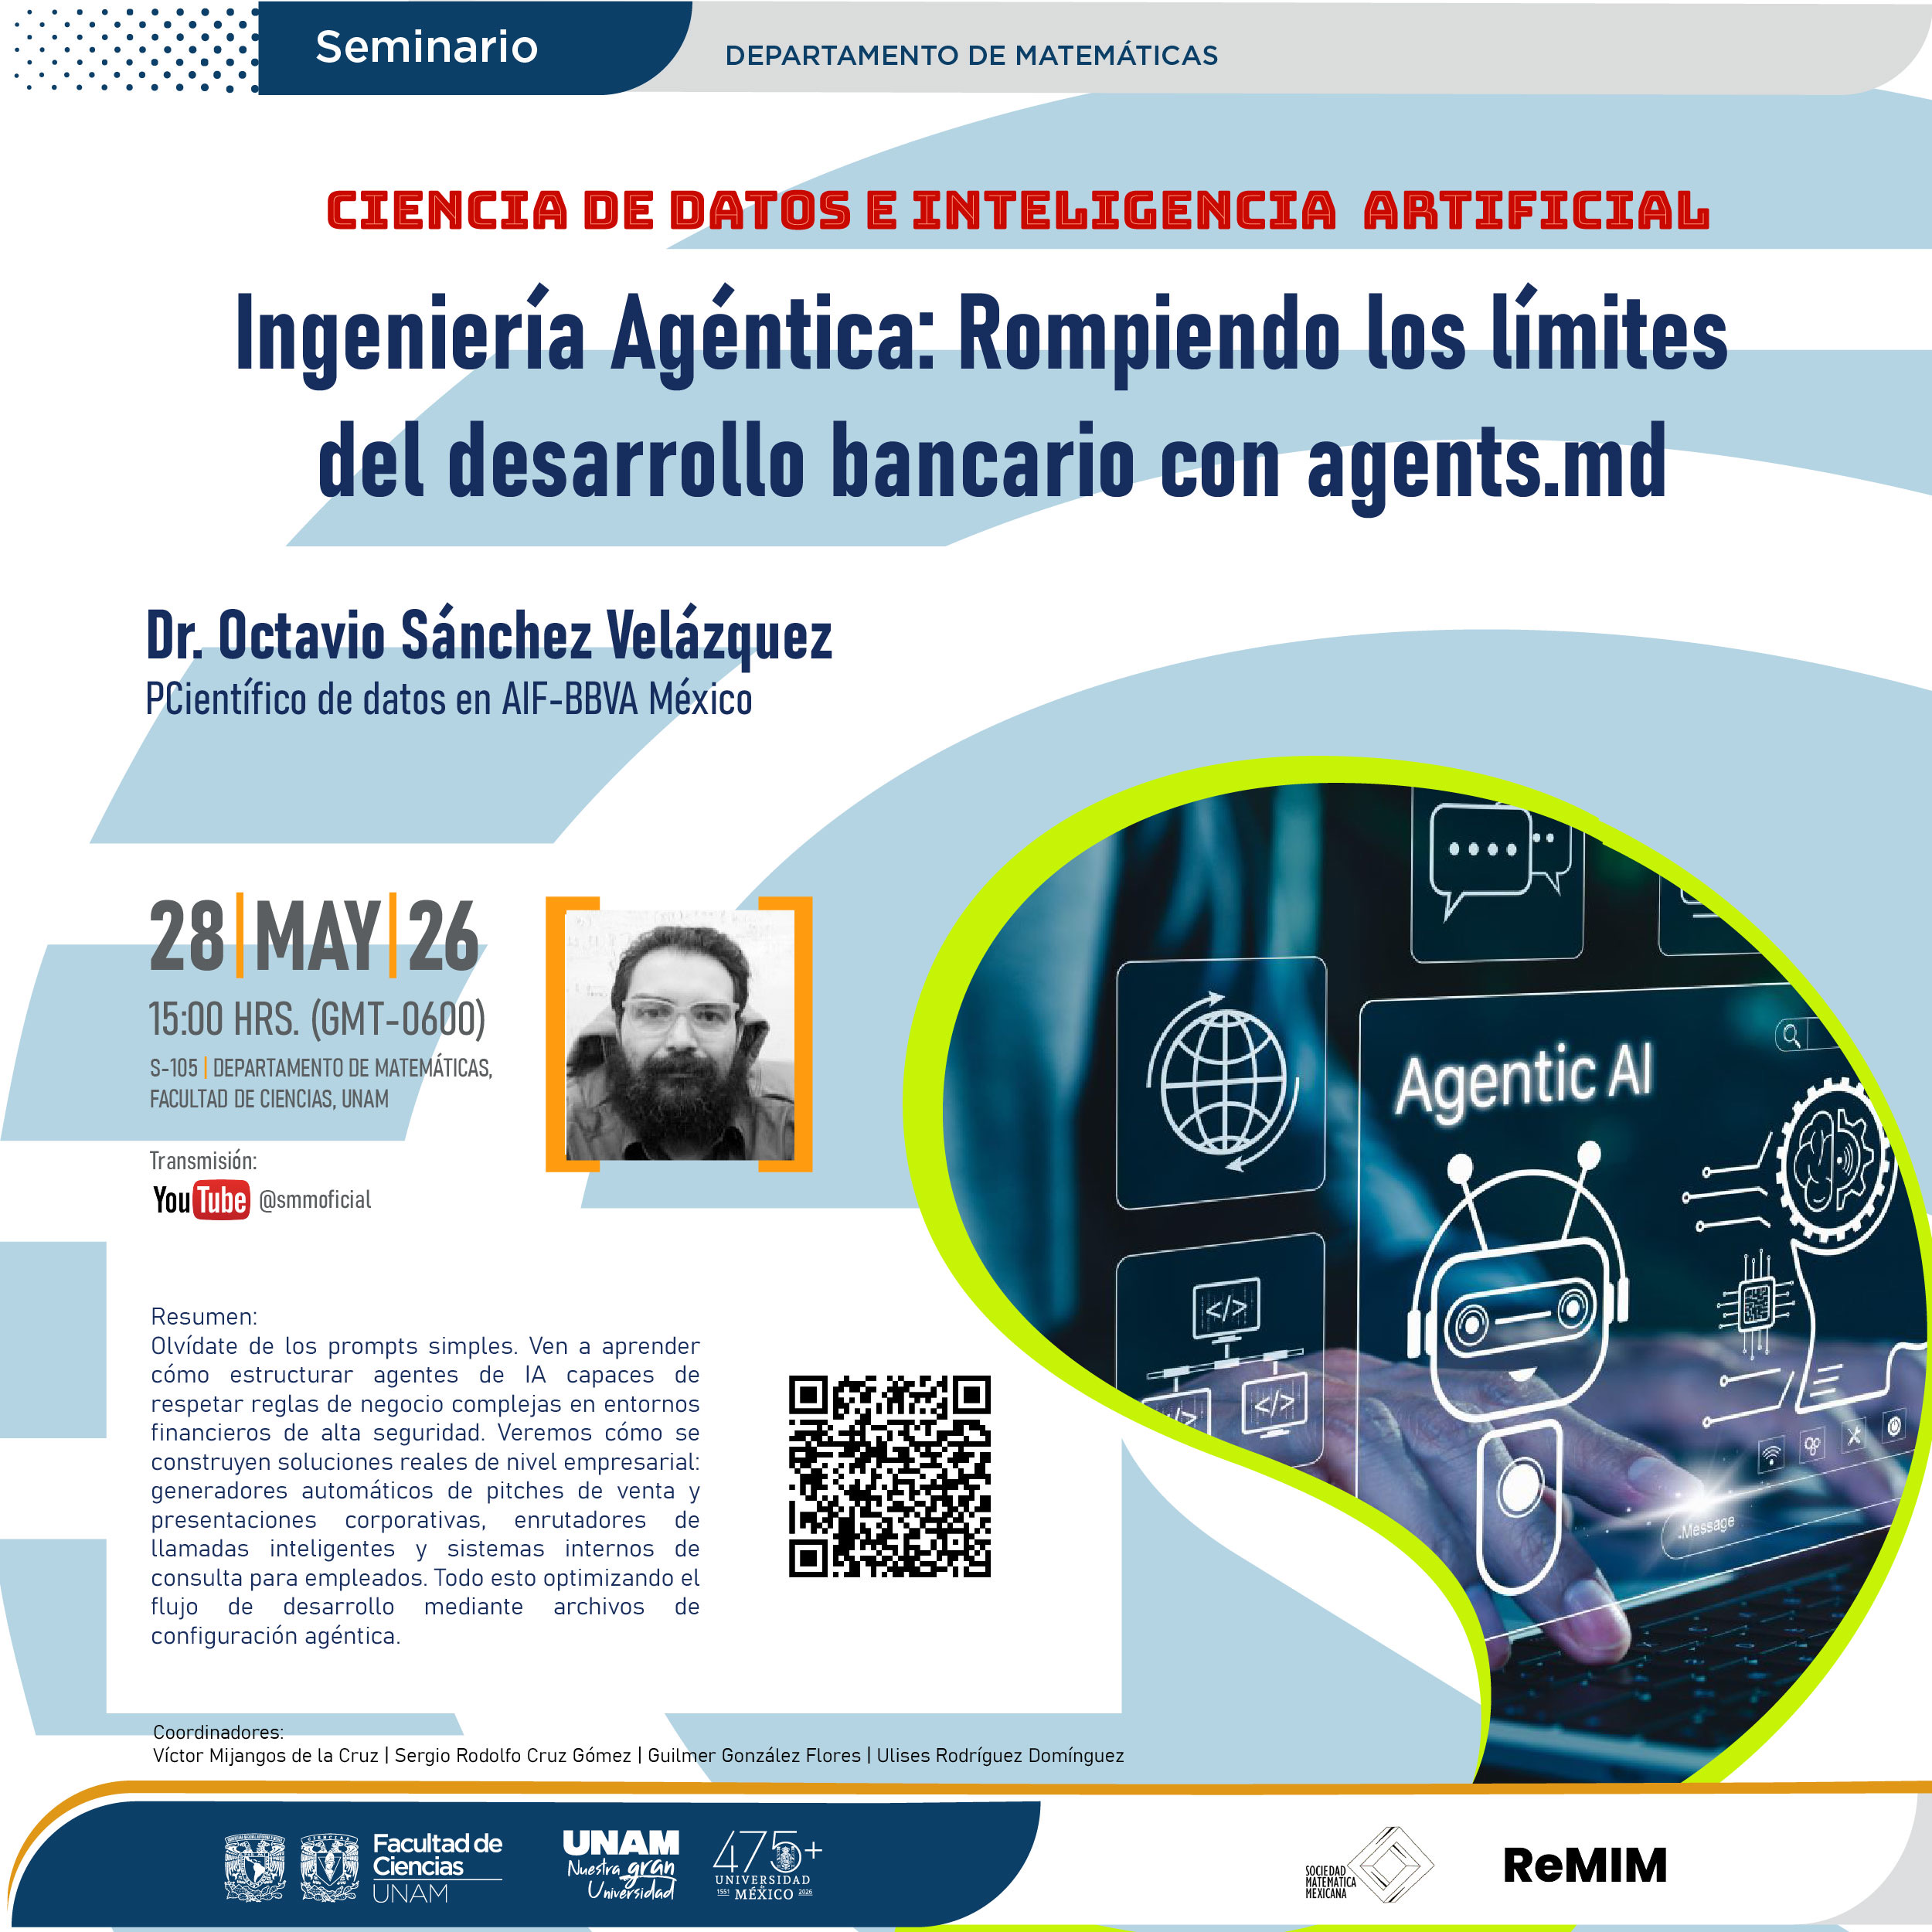
------------------------------------------ Título: Ingeniería Agéntica: Rompiendo los límites del desarrollo bancario con agents.md
Ponente: Mtro. Octavio Augusto Sánchez Velázquez Resumen: Olvídate de los prompts simples. Ven a aprender cómo estructurar agentes de IA capaces de respetar reglas de negocio complejas en entornos financieros de alta seguridad. Veremos cómo se construyen soluciones reales de nivel empresarial: generadores automáticos de pitches de venta y presentaciones corporativas, enrutadores de llamadas inteligentes y sistemas internos de consulta para empleados. Todo esto optimizando el flujo de desarrollo mediante archivos de configuración agéntica.
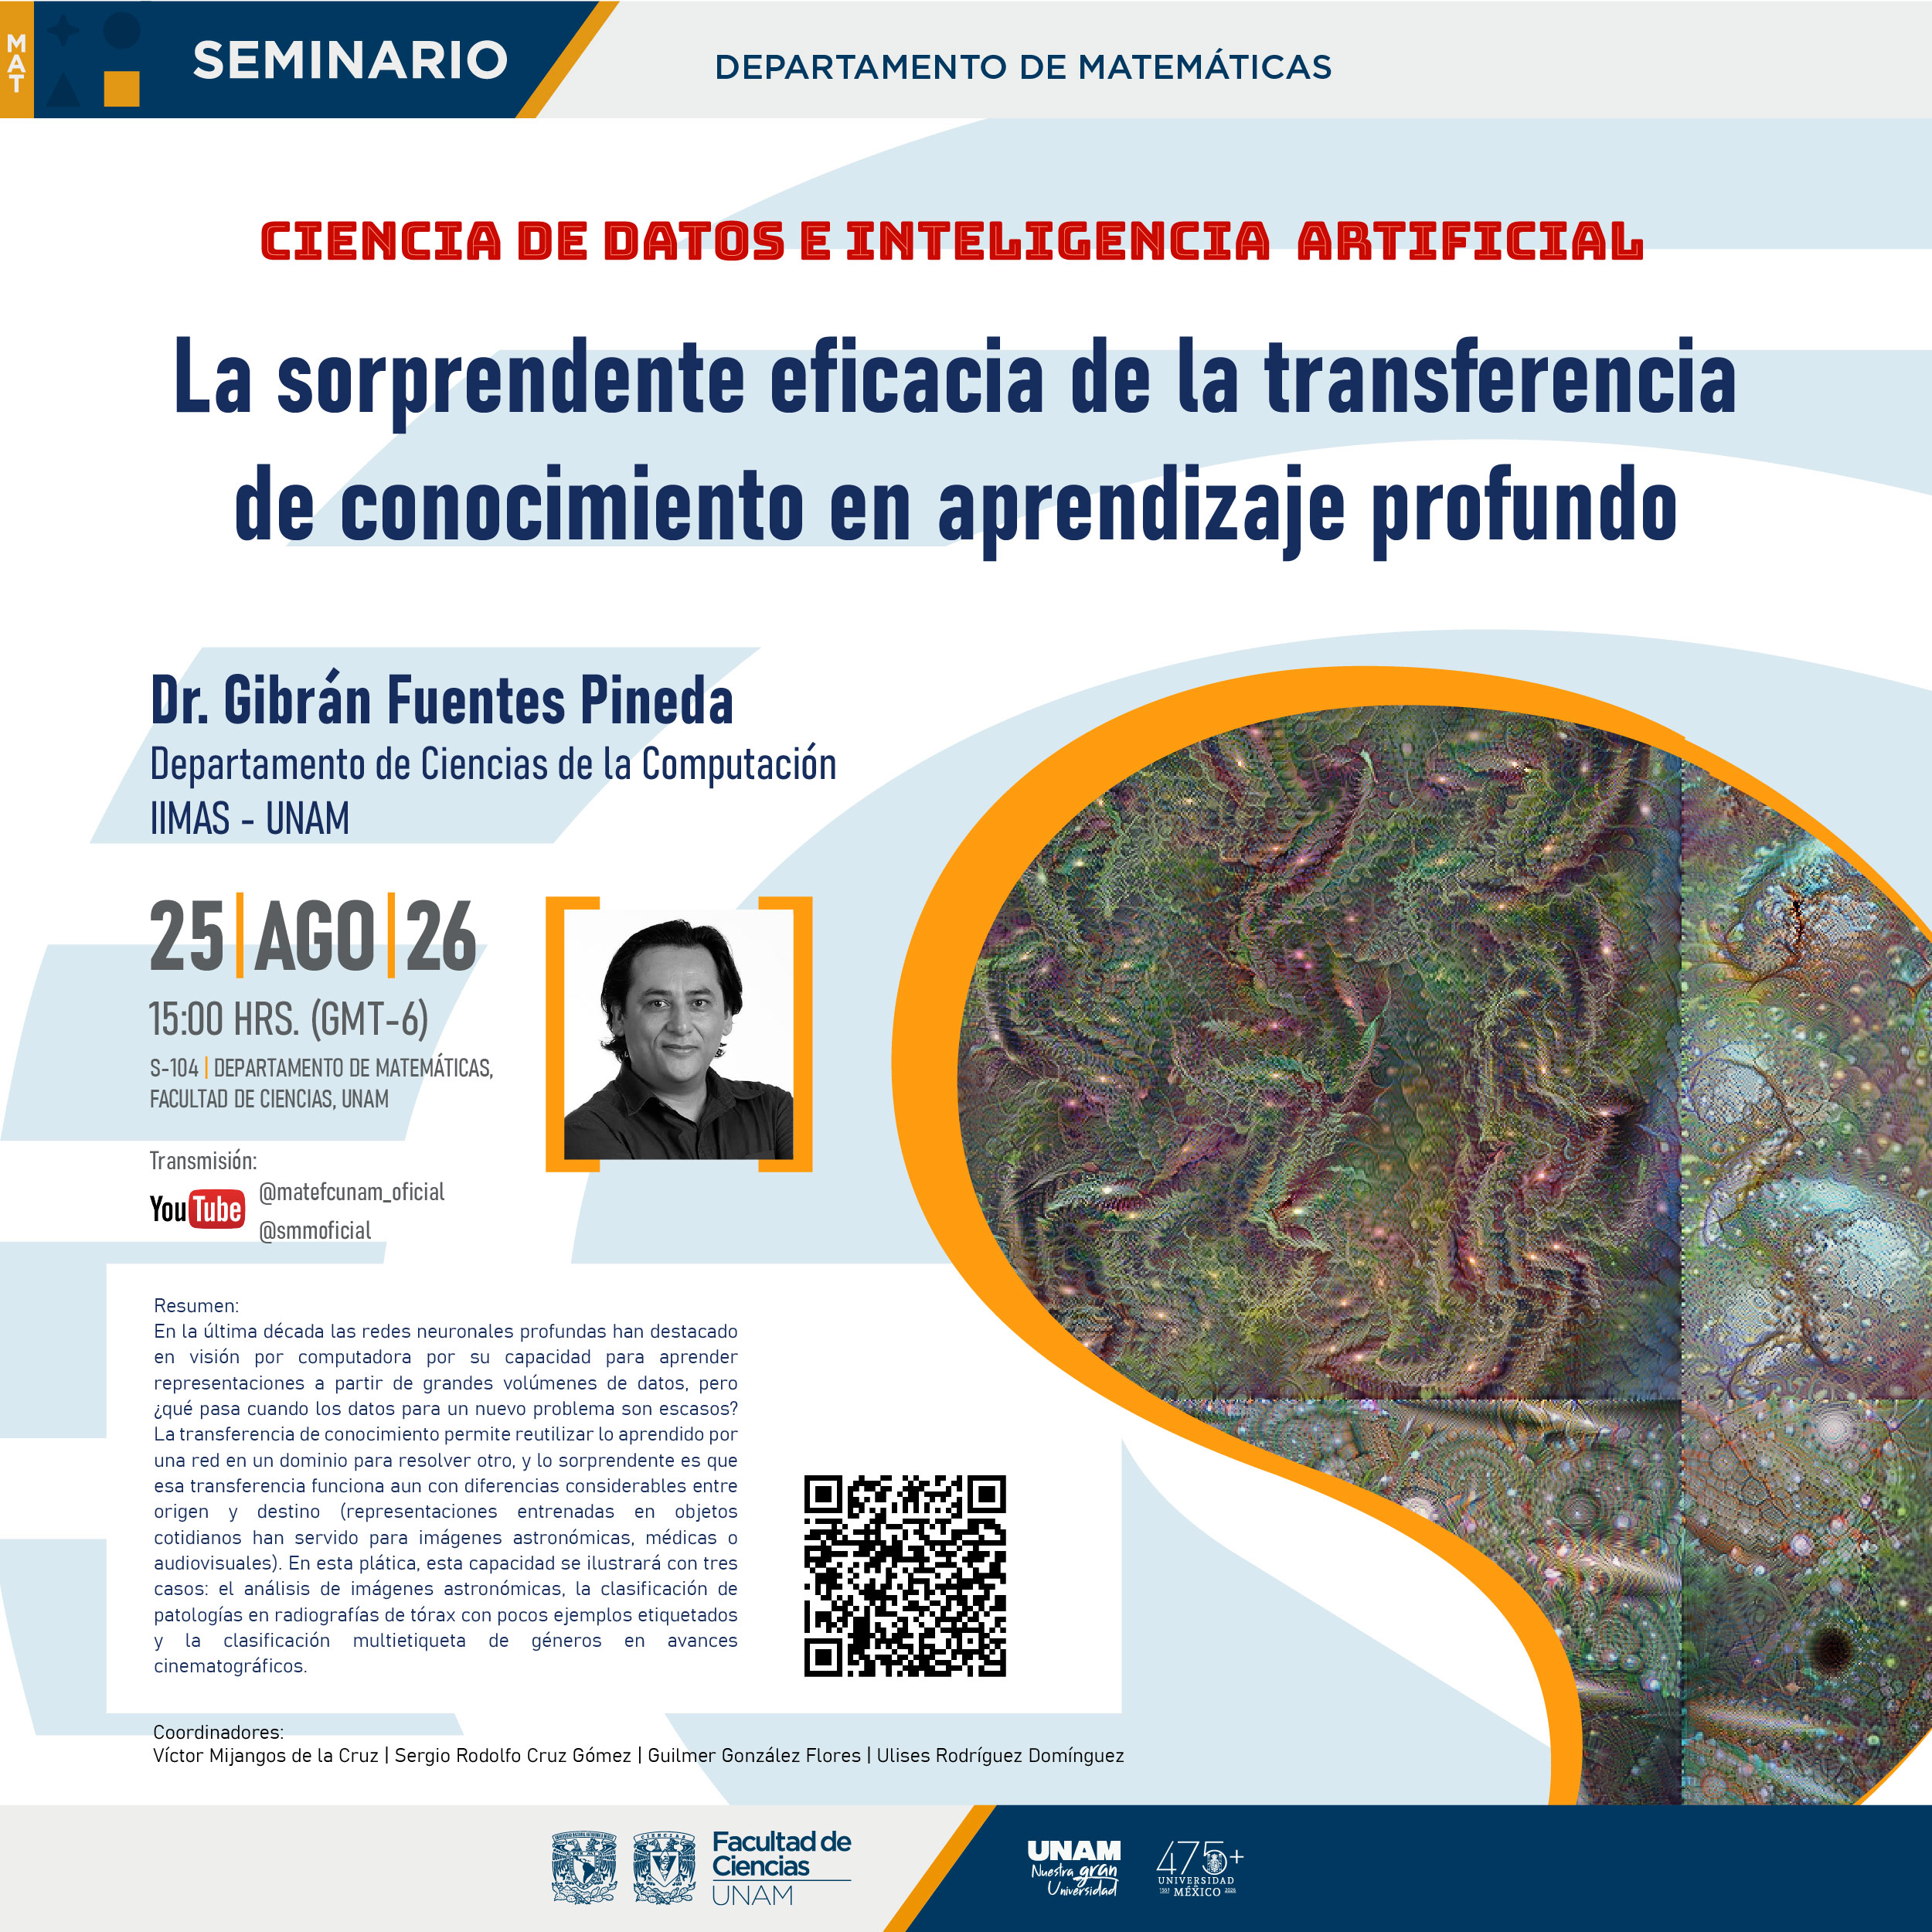
------------------------------------------ Título: La sorprendente eficacia de la transferencia de conocimiento en aprendizaje profundo
Ponente: Dr. Gibrán Fuentes Pineda (IIMAS, UNAM) Resumen: En la última década, las redes neuronales profundas se han consolidado como una de las herramientas más exitosas para abordar una amplia variedad de problemas de visión por computadora. Gran parte de este éxito se debe a su capacidad para aprender representaciones útiles a partir de grandes cantidades de datos. Pero, ¿qué ocurre cuando los datos disponibles para un nuevo problema son escasos? Una estrategia común consiste en reutilizar el conocimiento aprendido por una red entrenada previamente en otro conjunto de datos. Esta idea, conocida como transferencia de conocimiento, permite aprovechar representaciones aprendidas en un problema para resolver otros. Lo sorprendente es que este conocimiento puede resultar útil incluso cuando existe una diferencia considerable entre los problemas de origen y de destino. En particular, representaciones aprendidas a partir de grandes colecciones de imágenes de objetos cotidianos han demostrado ser útiles para tareas tan diversas como el análisis de imágenes astronómicas, la interpretación de imágenes médicas o la clasificación de contenido audiovisual. En esta plática se explorará la capacidad de las redes profundas para transferir conocimiento entre diferentes dominios y tareas, ilustrándola con tres casos de estudio: el análisis de imágenes astronómicas, la clasificación de patologías en radiografías de tórax con muy pocos ejemplos etiquetados y la clasificación multietiqueta de géneros en avances cinematográficos.
------------------------------------------ Título: Aprender con pocos ejemplos: del sobreajuste a la detección de objetos few-shot
Ponente: Dr. Sergio Rodolfo Cruz Gómez (Facultad de Ciencias, UNAM) Resumen: ¿Cuánto necesita ver una red neuronal para reconocer algo nuevo? Un niño aprende qué es un pangolín con una sola foto; un detector de objetos convencional necesita miles de cajas anotadas. En esta sesión veremos por qué las CNN sobreajustan cuando los datos escasean, por qué el ajuste fino no basta, y cómo el aprendizaje con pocos ejemplos resuelve el problema. Tomaremos como caso de estudio Few-shot Object Detection via Feature Reweighting (Kang et al., ICCV 2019) y cerraremos con sus ecos en segmentación, generación de imágenes y los modelos de vocabulario abierto actuales.
------------------------------------------ Título:
Ponente: Dr. Víctor Germán Mijangos de la Cruz (Facultad de Ciencias, UNAM) Resumen: Los actuales grandes modelos del lenguaje, como ChatGPT, Gemini, Copilot y demás, se basan en una arquitectura de red neuornal: los Transformers. Aunque un Transformer está compuesto por múltiples módulos de procesamiento, gran parte de su capacidad para modelar el lenguaje se concentra en un mecanismo fundamental: la atención. Entender el funcionamiento de redes neuronales profundas no es tarea sencilla. Por tanto, se requiere utilizar modelos matemáticos que puedan explicar el funcionamiento de estos modelos cuando se aplican a problemas específicos. La teoría de categorías es una de estas herramientas, pues permite describir cómo interactúan las capas internas en el modelo y, al mismo tiempo, permiten "traducir" esta explicación al tipo de datos de entrada. En esta plática exploraremos los mecanismos de atención desde una perspectiva algebraica y categórica. En particular, utilizaremos álgebras monádicas para describir las relaciones que pueden surgir dentro de los mecanismos de atención y estudiaremos cómo estas estructuras pueden transportarse al dominio del lenguaje natural para tener un marco explicativo de las relaciones entre palabras. Esto nos permite entender cómo estos modelos entienden la "semántica" del lenguaje y, asimismo, nos habla de las limitantes que se pueden presentar al modelar el lenguaje natural con estas arquitecturas.
------------------------------------------ |
|
Universidad Nacional Autónoma de México 
Facultad de Ciencias 
|